Arsip Kategori: Teknologi & Digital

Decentralized AI (De-AI): Mengapa Infrastruktur AI Terdesentralisasi Menggeser Monopoli Big Tech dan Mengamankan Data Perusahaan

Pendahuluan: Dominasi Raksasa Cloud dan Kebutuhan Jalur Alternatif

Memasuki pertengahan tahun 2026, ketergantungan sektor korporasi, startup teknologi, dan lembaga bisnis menengah di Indonesia terhadap teknologi Kecerdasan Buatan (Artificial Intelligence atau AI) telah mencapai tingkat ketergantungan mutlak. Kita menggunakan model bahasa besar (Large Language Models – LLM) untuk mengotomatisasi layanan pelanggan harian, menjalankan algoritma analisis prediktif penjualan, hingga melakukan penyaringan data sensitif perusahaan.

Namun, di balik lompatan efisiensi tersebut, timbul satu tantangan struktural yang kian mengancam kelangsungan hidup finansial dan keamanan data organisasi: monopoli absolut dari penyedia infrastruktur awan terpusat (centralized cloud giants) seperti Amazon Web Services (AWS), Google Cloud Platform (GCP), Microsoft Azure, serta penyedia model AI monolitik seperti OpenAI.

Biaya sewa daya komputasi unit pemroses grafis (GPU hosting) untuk melatih dan menjalankan model AI kustom terus melambung tinggi akibat kelangkaan chip semikonduktor global. Selain itu, menyalurkan data rahasia operasional bisnis Anda ke server pihak ketiga milik raksasa teknologi berisiko tinggi memicu pelanggaran privasi siber dan ketidakpatuhan hukum yang fatal harian.

Sebagai respon terhadap kebuntuan sistem terpusat ini, lanskap teknologi Web3 menghadirkan sebuah paradigma baru yang revolusioner bernama Decentralized AI (De-AI) atau Kecerdasan Buatan Terdesentralisasi. De-AI adalah praktik melatih, menjalankan, dan mengoperasikan model kecerdasan buatan di atas jaringan infrastruktur komputer terdistribusi yang aman secara kriptografi, tanpa dikendalikan oleh satu pun entitas tunggal.

Bagi pembaca setia Bizonara.com, memahami arsitektur De-AI adalah kunci untuk memotong biaya operasional server AI Anda hingga $60\%$ sekaligus melindungi kedaulatan data sensitif perusahaan Anda dari ancaman kebocoran siber. Artikel ini akan membedah secara ilmiah dan taktis cara kerja sistem De-AI, formulasi efisiensi biaya, serta langkah praktis menerapkannya di Indonesia.

Perspektif Sains Teknologi: Menghitung Indeks Keuntungan De-AI ($DAI$)

Dalam mengoptimalkan infrastruktur teknologi informasi modern, beralih ke sistem terdesentralisasi harus divalidasi dengan kalkulasi matematis yang akurat. Kita tidak boleh mengadopsi teknologi murni karena tren viral sesaat harian.

Secara teknis dan finansial, tingkat kesehatan dan efisiensi pengembalian dari transisi infrastruktur komputasi AI Anda dari awan terpusat ke jaringan terdesentralisasi dapat diukur secara kuantitatif melalui Decentralized AI Index ($DAI$):

$$DAI = \frac{C_{\text{compute}} \times P_{\text{privacy}}}{C_{\text{latency}} + C_{\text{gas}}}$$

Di mana:

  • $C_{\text{compute}}$ adalah total nilai penghematan biaya sewa daya komputasi GPU/CPU (Compute Cost Savings) yang diperoleh dari menyewa infrastruktur urun daya terdistribusi dibandingkan dengan tarif pasar cloud terpusat konvensional.
  • $P_{\text{privacy}}$ adalah skor perlindungan privasi data dan kedaulatan informasi (Data Sovereignty and Privacy Protection Score), berskala desimal $1.0$ hingga $10.0$. Sistem De-AI yang memanfaatkan enkripsi homomorfik (homomorphic encryption) atau komputasi multi-pihak yang aman (multi-party computation) menjamin bahwa data rahasia Anda tidak dapat dibaca oleh pemilik node komputer penyedia daya sekalipun.
  • $C_{\text{latency}}$ adalah faktor gesekan keterlambatan respons waktu pemrosesan data jaringan terdistribusi (Network Latency and Synchronization Overhead), dihitung dari jeda milidetik pengiriman token data melintasi node terdesentralisasi secara global harian.
  • $C_{\text{gas}}$ adalah biaya administrasi transaksi blockchain (Gas and Protocol Transaction Fees) yang wajib dikeluarkan untuk mengeksekusi kontrak pintar koordinasi komputasi harian.

Secara analisis manajemen infrastruktur IT, implementasi Decentralized AI Bisnis Indonesia dinyatakan sangat sehat, efisien, dan memberikan keuntungan kompetitif yang matang apabila menghasilkan nilai indeks $DAI \ge 2,5$. Ini membuktikan bahwa nilai penghematan pengeluaran finansial ($C_{\text{compute}}$ tinggi) dan jaminan perlindungan kedaulatan data pribadi ($P_{\text{privacy}}$ tinggi) jauh lebih besar daripada gesekan teknis latensi jaringan terdistribusi ($C_{\text{latency}}$ rendah harian) yang Anda alami selama proses komputasi berlangsung harian.

5 Pilar Strategis Menerapkan Decentralized AI (De-AI) dalam Bisnis

To merestrukturisasi infrastruktur AI perusahaan Anda dari model kaku terpusat menuju kelincahan ekosistem terdesentralisasi, terapkan lima pilar taktis operasional berikut:

1. Memanfaatkan Jaringan GPU Terdesentralisasi (Decentralized GPU Networks)

Melatih LLM kustom atau menjalankan kalkulasi model prediksi penjualan berskala besar membutuhkan kekuatan akselerator grafis premium (seperti Nvidia H100 atau A100) yang biaya sewanya di AWS sangat menguras anggaran modal kerja harian.

  • Actionable Step: Manfaatkan platform jaringan penyedia daya GPU terdesentralisasi berbasis Web3 (seperti io.net, Akash Network, atau Render Network). Platform-platform ini bertindak sebagai agregator yang mengumpulkan sisa daya GPU menganggur (idle GPUs) milik pusat data independen, studio desain, hingga komputer penambang kripto di seluruh dunia secara kolektif. Menyewa daya di jaringan ini terbukti memberikan penghematan biaya operasional komputasi hingga $60\% – 80\%$ dari tarif standar pasar cloud terpusat konvensional harian.

2. Kepatuhan Pelindungan Data Radikal Melalui Enkripsi Homomorfik (Homomorphic Encryption)

Salah satu ketakutan terbesar eksekutif saat menggunakan asisten AI publik adalah kekhawatiran bahwa draf dokumen paten, rahasia dagang, atau data transaksi nasabah Anda akan dibaca, direkam, dan dijadikan bahan latihan algoritma oleh penyedia model AI eksternal harian.

  • Actionable Step: Gunakan arsitektur De-AI yang mengintegrasikan metode FHE (Fully Homomorphic Encryption) atau teknik komputasi multi-pihak yang aman (Secure Multi-Party Computation – SMPC). Teknologi enkripsi ini memungkinkan model AI untuk melakukan kalkulasi analisis kognitif langsung di atas data Anda yang masih berada dalam kondisi terenkripsi murni. Pemilik server komputer terdistribusi yang memproses data Anda hanya melihat potongan kode acak terenkripsi, tanpa pernah bisa membaca informasi data mentah aslinya harian.

3. Beralih ke Penggunaan Model Terbuka Mandiri (Open-Source LLMs)

Bergantung pada API model berbayar tertutup (seperti GPT-4 milik OpenAI) membuat bisnis Anda rentan terhadap risiko perubahan tarif harga sepihak, kegagalan server tersentralisasi (outage), serta sensor filter konten yang kaku harian.

  • Actionable Step: Lakukan migrasi ke arah penggunaan model bahasa besar berlisensi terbuka (open-source LLMs seperti Llama 3 milik Meta, Mistral, atau Phi milik Microsoft). Pasang model-model terbuka ini di dalam server terenkripsi mandiri Anda atau sewa instansi di jaringan De-AI. Dengan melakukan proses pelatihan tambahan menggunakan data internal (fine-tuning), model terbuka yang ringkas terbukti mampu menghasilkan akurasi pemecahan masalah spesifik yang setara dengan model tertutup raksasa, dengan biaya operasional token API harian mendekati nol harian.

4. Kepatuhan Regulasi Hukum UU PDP No. 27/2022 di Indonesia

Implementasi kecerdasan buatan wajib menghormati kedaulatan data hukum perdata nasional yang diatur ketat oleh negara harian.

  • Regulasi Lokal: Berdasarkan Undang-Undang Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi (UU PDP) di Indonesia, pengendali data dilarang keras mengirimkan data pribadi mentah pelanggan keluar wilayah hukum Indonesia tanpa adanya jaminan perlindungan yang setara dan persetujuan eksplisit (explicit consent) dari pemilik data.
  • Actionable Step: Dengan mengadopsi De-AI berbasis enkripsi homomorfik atau menyimpan model LLM secara mandiri di node lokal dalam negeri, Anda menjamin bahwa data pribadi pelanggan (seperti NIK, nama lengkap, atau alamat fisik) tidak pernah meninggalkan wilayah kedaulatan siber Indonesia dalam bentuk mentah terenkripsi, membebaskan startup Anda dari risiko denda denda pelanggaran UU PDP negara yang sangat berat harian.

5. Kontribusi dan Monetisasi Aset Data Terdesentralisasi (Tokenized Data Incentives)

Di era 2026, data berkualitas tinggi dan terkurasi dengan rapi adalah emas digital baru. Perusahaan menengah yang memiliki basis data riil industri yang bersih kini dapat memonetisasi aset non-fisik tersebut secara aman tanpa membocorkan privasi.

  • Actionable Step: Berpartisipasilah sebagai penyedia data latihan (data provider) di protokol data terdesentralisasi (seperti Ocean Protocol atau Bittensor). Anda dapat menyewakan akses analisis ke basis data terkurasi Anda untuk melatih model AI pihak ketiga global secara aman via smart contracts, menghasilkan aliran pendapatan pasif bersih baru (recurring revenue) berbentuk aset digital yang dapat dikonversi langsung menjadi Rupiah secara sah harian.

Kesimpulan: Menghancurkan Monopoli Demi Kebebasan Berinovasi

Revolusi kecerdasan buatan di tahun 2026 tidak boleh berujung pada penjajahan ekonomi baru di mana segelintir raksasa teknologi (Big Tech) memegang kendali mutlak atas seluruh daya komputasi, model kognitif, dan kerahasiaan data dunia harian. Decentralized AI (De-AI) adalah instrumen emansipasi teknologi nyata yang mengembalikan kendali kedaulatan, keamanan, dan efisiensi finansial seutuhnya ke tangan para pengusaha, startup, dan pelaku bisnis menengah secara adil harian.

Bagi Anda pengambil keputusan teknologi pembaca setia Bizonara.com, mulailah melangkah keluar dari ketergantungan kaku sistem cloud tersentralisasi yang mahal harian. Rancanglah arsitektur IT hibrida perusahaan Anda dengan menyambungkan pipeline model terbuka mandiri, manfaatkan sewa daya GPU di jaringan terdesentralisasi Web3 yang super murah, proteksilah privasi data pelanggan Anda sesuai amanat hukum UU PDP negara secara patuh, dan pimpinlah pasar dengan inovasi kecerdasan buatan yang lincah, aman, mandiri, berkah, tepercaya, serta melesat tumbuh tanpa batas di masa kini dan masa depan.
Synthetic Data Generation: Solusi Cerdas Perusahaan Melatih Model AI Tanpa Melanggar Privasi dan Aturan UU PDP No. 27/2022

Pendahuluan: Krisis Bahan Baku AI di Tengah Benteng Privasi Global

Pada tahun 2026, kecerdasan buatan (Artificial Intelligence) telah menjadi motor penggerak utama bagi efisiensi operasional korporasi dan inovasi produk digital. Namun, para pengembang AI, direktur teknologi (CTO), dan ilmuwan data (data scientists) di seluruh dunia kini menghadapi satu tantangan sistemik yang sama: krisis kelangkaan data latih berkualitas tinggi (the data wall). Untuk menghasilkan model AI yang akurat, cerdas, dan minim bias, algoritma pembelajaran mesin membutuhkan asupan data historis dalam skala yang sangat masif.

Di sisi lain, era eksploitasi data publik secara bebas telah resmi berakhir. Kesadaran masyarakat akan hak privasi digital berada di titik tertinggi, didukung oleh implementasi sanksi hukum perlindungan data yang sangat ketat di berbagai negara. Di Indonesia, penegakan hukum terhadap pelanggaran kerahasiaan data pribadi kini diawasi secara ketat tanpa kompromi. Menambang data transaksi, riwayat medis, atau perilaku digital pelanggan riil secara langsung untuk melatih model AI internal perusahaan tanpa izin tertulis yang sah adalah tindakan ilegal yang membawa konsekuensi hukum luar biasa berat.

Bagi pembaca setia Bizonara.com, dilema operasional ini membutuhkan solusi arsitektur data yang revolusioner: Synthetic Data Generation (Pembuatan Data Sintetis). Data sintetis adalah data tiruan yang dihasilkan secara artifisial oleh algoritma komputer (seperti model generatif AI) yang memiliki karakteristik statistik, pola perilaku, dan korelasi matematis yang identik dengan data dunia nyata (real-world data), namun sepenuhnya bebas dari informasi identitas pribadi (Personally Identifiable Information – PII). Artikel ini akan membedah secara ilmiah dan taktis bagaimana data sintetis menjadi solusi cerdas melatih AI, merumuskan indeks kualitas data sintetis, serta menavigasi kepatuhan hukum di Indonesia.

Perspektif Sains Data: Menghitung Indeks Kualitas Data Sintetis ($SDG$)

Memproduksi data sintetis bukan sekadar membuat angka atau teks acak menggunakan komputer. Data sintetis yang buruk dan tidak representatif justru akan merusak performa model AI Anda (garbage in, garbage out) atau melestarikan bias kognitif yang berbahaya.

Untuk mengukur kelayakan, akurasi, dan keamanan dari data sintetis yang Anda hasilkan sebelum digunakan untuk melatih model AI, kita dapat merumuskan Synthetic Data Generation Index ($SDG$):

$$SDG = \frac{F_{\text{fidelity}} \times P_{\text{privacy}}}{C_{\text{generation}} \times E_{\text{bias}}}$$

Di mana:

  • $F_{\text{fidelity}}$ (Fidelity) adalah tingkat kemiripan statistik dan akurasi pola (statistical similarity) antara data sintetis dengan data riil asli. Jika model AI dilatih menggunakan data sintetis dengan fidelitas tinggi, ia harus menghasilkan tingkat akurasi prediksi yang sama persis dengan jika ia dilatih menggunakan data riil.
  • $P_{\text{privacy}}$ (Privacy Protection) adalah skor kekuatan perlindungan privasi, mengukur ketahanan data sintetis terhadap serangan rekonstruksi data (membership inference attacks). Data sintetis harus memastikan bahwa tidak ada satu pun baris data tiruan yang dapat dilacak balik untuk mengungkap identitas individu nyata di dunia nyata.
  • $C_{\text{generation}}$ (Computational Cost) adalah biaya daya komputasi, waktu, dan infrastruktur server yang dihabiskan untuk melatih model generatif guna memproduksi data sintetis tersebut.
  • $E_{\text{bias}}$ (Bias Entropy) adalah tingkat bias atau ketidakseimbangan sistemik yang terkandung di dalam data sintetis. Salah satu keunggulan data sintetis adalah kemampuan manusia untuk merekayasa keseimbangan data (data balancing) guna menghilangkan bias rasial, gender, atau kelas sosial yang sering kali melekat pada data riil historis.

Secara analisis sains data, sebuah dataset tiruan dinyatakan sangat berkualitas dan aman digunakan untuk kebutuhan komersial apabila memiliki nilai indeks $SDG \ge 2.0$. Ini membuktikan bahwa data sintetis Anda memiliki kemiripan pola yang tinggi ($F_{\text{fidelity}}$ optimal) dan perlindungan privasi yang tangguh ($P_{\text{privacy}}$ tinggi), sementara bias sistemik berhasil ditekan ($E_{\text{bias}}$ rendah) dengan biaya komputasi ($C_{\text{generation}}$) yang efisien.

5 Pilar Strategis Implementasi Pembuatan Data Sintetis (Synthetic Data Generation)

Untuk mengadopsi teknologi data sintetis di perusahaan Anda secara aman, terarah, dan fungsional, terapkan lima pilar strategis berikut:

1. Pemilihan Arsitektur Generatif yang Tepat (GANs vs. VAEs vs. Diffusion)

Langkah awal adalah menentukan teknologi algoritma yang akan bertindak sebagai pabrik pembuat data sintetis Anda. Ada tiga arsitektur utama yang dominan digunakan di tahun 2026:

  • Generative Adversarial Networks (GANs): Sangat tangguh untuk memproduksi data visual (gambar/video) dan data tabular terstruktur. GANs bekerja dengan mempertemukan dua jaringan saraf: Generator (yang membuat data palsu) dan Discriminator (yang menilai apakah data tersebut asli atau palsu) hingga menghasilkan data tiruan yang sangat realistis.
  • Variational Autoencoders (VAEs): Sangat baik untuk menghasilkan data tabular keuangan atau data medis terstruktur yang membutuhkan kepatuhan distribusi probabilitas statistik yang ketat.
  • Diffusion Models: Standar emas baru untuk menghasilkan data tidak terstruktur skala besar (gambar resolusi tinggi, audio, dan teks kompleks).

2. Penjaminan Kepatuhan Privasi Menggunakan Metode Differential Privacy

Salah satu risiko terbesar dari data sintetis yang dihasilkan oleh AI adalah terjadinya overfitting—kondisi di mana model generatif meniru data riil secara terlalu detail, sehingga tanpa sengaja menyisipkan data pribadi asli ke dalam hasil sintetisnya.

  • Actionable Step: Terapkan teknik matematika Differential Privacy (DP) selama proses pelatihan model generatif Anda. Teknik DP bekerja dengan cara menambahkan gangguan matematis halus (mathematical noise) yang terukur ke dalam dataset asli selama pelatihan. Gangguan ini memastikan bahwa karakteristik makro data tetap terjaga, namun informasi mikro yang dapat mengidentifikasi individu secara spesifik terhapus secara permanen dari memori model generatif AI Anda.

3. Validasi Fidelitas Statistik Melalui Pengujian Empiris

Sebelum melepas dataset sintetis Anda ke dalam sistem pelatihan AI utama, Anda wajib membuktikan secara ilmiah bahwa data tersebut memiliki kualitas fungsional yang setara dengan data asli.

  • Actionable Step: Lakukan pengujian komparasi statistik secara ketat harian. Gunakan metrik seperti Wasserstein Distance atau Kullback-Leibler Divergence untuk mengukur seberapa dekat distribusi probabilitas data sintetis Anda dengan data riil. Jalankan juga uji fungsional Train on Synthetic, Test on Real (TSTR): latih model klasifikasi AI Anda menggunakan data sintetis, lalu uji kinerjanya menggunakan data riil. Jika akurasi model tetap stabil, itu adalah bukti sah bahwa data sintetis Anda memiliki fidelitas yang tinggi.

4. Memanfaatkan Data Sintetis untuk Menghilangkan Bias Data Historis

Data riil di dunia nyata sering kali mencerminkan ketidakadilan sosial masa lalu. Sebagai contoh, jika data riil persetujuan kredit pinjaman bank masa lalu didominasi oleh kelompok gender tertentu akibat bias historis manusia, AI yang dilatih dengan data tersebut akan meneruskan diskriminasi serupa.

  • Actionable Step: Gunakan data sintetis sebagai instrumen keadilan sosial digital (algorithmic fairness). Instruksikan model generatif Anda untuk memproduksi sampel data tambahan khusus (upsampling) bagi kelompok-kelompok minoritas yang datanya kurang terwakili di dunia nyata (underrepresented classes). Rekayasa data sintetis yang seimbang ini akan melahirkan model keputusan AI yang jauh lebih adil, objektif, dan bebas dari bias diskriminatif harian.

5. Membangun Ekosistem Pengawasan dan Tata Kelola Data Sintetis

Sama seperti data riil, data sintetis membutuhkan tata kelola pelabelan, penyimpanan, dan dokumentasi yang rapi guna menjaga integritas operasional sistem siber perusahaan.

  • Actionable Step: Buat kebijakan pelabelan metadata yang sangat transparan. Setiap dataset yang digunakan di dalam sistem IT perusahaan harus memiliki tanda pengenal yang jelas: Apakah ini data asli, data hibrida (gabungan), atau 100% data sintetis? Simpan model generatif pembuat data sintetis Anda di dalam repositori server terenkripsi yang aman guna menghindari penyalahgunaan oleh pihak internal untuk membuat data transaksi fiktif yang melanggar kepatuhan audit keuangan.

Navigasi Hukum: UU PDP No. 27/2022 dan Kepatuhan Regulasi di Indonesia

Penerapan teknologi Synthetic Data Latih AI di Indonesia berjalan sangat selaras dengan komitmen perlindungan hak asasi manusia digital yang diamanatkan oleh pemerintah:

  • Undang-Undang Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi (UU PDP): Secara tegas menyatakan bahwa data pribadi adalah data tentang orang perseorangan yang teridentifikasi atau dapat diidentifikasi secara tersendiri atau dikombinasikan dengan informasi lainnya. Pelanggaran terhadap pemrosesan data pribadi tanpa dasar hukum yang sah (lawful basis) dapat dijatuhi denda administratif hingga $2\%$ dari pendapatan tahunan korporasi, serta tuntutan pidana kurungan.
  • Solusi Hukum Data Sintetis: Karena data sintetis yang sesungguhnya ($SDG \ge 2.0$) tidak mengandung unsur data pribadi yang dapat mengidentifikasi individu riil, maka penggunaan, transmisi, perdagangan, dan pemanfaatan data sintetis untuk pelatihan model AI dibebaskan sepenuhnya dari yurisdiksi kepatuhan UU PDP. Ini memberikan kepastian hukum yang mutlak bagi korporasi dan startup tekfin lokal di Indonesia untuk terus berinovasi mengejar ketertinggalan teknologi tanpa dibayangi ketakutan sanksi denda hukum negara.

Kesimpulan: Menguasai Masa Depan AI Tanpa Menumbalkan Privasi

Kunci sukses dominasi bisnis di era kecerdasan buatan tahun 2026 tidak lagi ditentukan oleh siapa yang paling nekat menguras data privasi pelanggan demi melatih mesin mereka harian. Pemenang sesungguhnya adalah organisasi yang memiliki kecerdasan arsitektur untuk memproduksi bahan baku data berkualitas mereka sendiri secara mandiri, aman, dan etis. Synthetic Data Generation bukan lagi sekadar alternatif teknologi penyelamat, melainkan standar industri baru yang menjembatani antara kemajuan inovasi AI dengan kehormatan hak privasi manusia.

Bagi Anda pengambil keputusan teknologi pembaca setia Bizonara.com, mulailah mentransformasikan pipeline manajemen data Anda ke arah desentralisasi sintetis sejak hari ini. Latihlah model generatif internal Anda dengan aman, terapkan metode diferensiasi privasi yang tangguh, hilangkan bias data masa lalu demi keputusan AI yang lebih adil, dan pimpinlah industri dengan reputasi perusahaan yang tidak hanya cerdas secara teknologi, melainkan berintegritas tinggi menghormati hak asasi digital bangsa Indonesia.

Program Loyalitas Berbasis AI: Berikan Reward Dinamis yang Meningkatkan LTV Pelanggan secara Eksponensial

Pendahuluan: Kematian Sistem Poin dan Kartu Stempel Tradisional

Selama beberapa dekade, strategi retensi pelanggan di sektor ritel dan e-commerce bersandar pada metode yang sangat seragam dan statis: kartu stempel fisik, sistem pengumpulan poin linier, atau diskon umum ulang tahun sebesar $10\%$. Di bawah paradigma lama ini, setiap pelanggan—tanpa memedulikan preferensi belanja, daya beli, frekuensi transaksi, atau ikatan emosional mereka—diperlakukan dengan cara yang sama persis oleh sistem manajemen hubungan pelanggan (Customer Relationship Management – CRM).

Namun, memasuki tahun 2026, sistem loyalitas tradisional tersebut tidak lagi efektif untuk mempertahankan pelanggan. Konsumen modern, khususnya generasi milenial dan Gen Z perkotaan yang lincah secara digital, telah mengalami kejenuhan program loyalitas (loyalty fatigue). Mereka enggan mengunduh aplikasi tambahan hanya untuk mengumpulkan poin yang sulit ditukarkan, bosan menerima email penawaran massal yang tidak relevan, serta menolak skema reward kaku yang tidak sesuai dengan kebutuhan gaya hidup harian mereka secara instan.

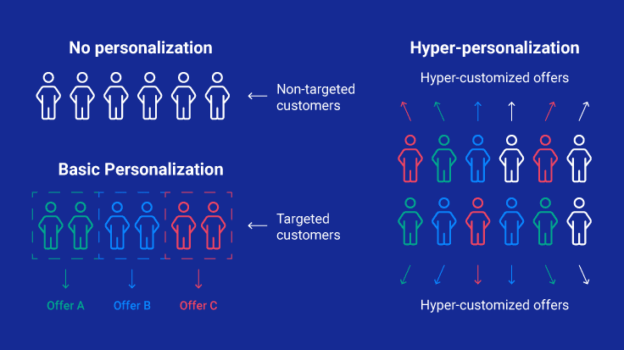
Bagi pelaku bisnis e-commerce dan pemilik merek lokal pembaca setia Bizonara.com, kondisi ini menuntut pergeseran taktis yang revolusioner. Kunci sukses retensi pelanggan saat ini adalah transisi menuju Hyper-Personalized Loyalty Programs (Program Loyalitas Berbasis AI) yang didukung oleh kecerdasan buatan (AI-powered loyalty engines). Alih-alih menyajikan skema poin statis, sistem AI di tahun 2026 mampu menganalisis ribuan titik data perilaku konsumen secara real-time untuk memberikan penawaran hadiah, insentif, dan apresiasi yang bersifat unik, dinamis, serta kontekstual bagi setiap individu pelanggan.

Artikel ini akan membedah secara ilmiah dan operasional formula keberhasilan program loyalitas berbasis kecerdasan buatan, pilar kekuatan personalisasi dinamis, serta langkah taktis mengimplementasikannya di bisnis Anda guna melipatgandakan nilai umur pelanggan (Lifetime Value – LTV) secara eksponensial.

Perspektif Sains Data: Menghitung Loyalty Reward Index ($LRI$)

Dalam analisis data bisnis modern, efisiensi keuangan dari program retensi harus diukur secara presisi untuk memastikan bahwa pengeluaran biaya hadiah (cost of rewards) benar-benar menghasilkan peningkatan loyalitas dan pengulangan transaksi yang menguntungkan, bukan sekadar memotong margin keuntungan bersih perusahaan.

Secara ilmiah, kita dapat mengukur efisiensi, dampak, dan kesehatan keuangan dari program loyalitas berbasis kecerdasan buatan di perusahaan Anda melalui formulasi Loyalty Reward Index ($LRI$):

$$LRI = \frac{R_{\text{redemption}} \times \Delta LTV}{C_{\text{reward}} \times F_{\text{friction}}}$$

Di mana:

  • $R_{\text{redemption}}$ adalah rasio penukaran hadiah (Reward Redemption Rate), yaitu persentase jumlah hadiah dinamis yang sukses diklaim atau ditukarkan oleh pelanggan dari total penawaran personal yang diberikan oleh sistem AI.

    $$R_{\text{redemption}} = \frac{\text{Rewards Redeemed}}{\text{Rewards Offered}}$$

  • $\Delta LTV$ adalah nilai peningkatan bersih umur pelanggan (Customer Lifetime Value Increase), dihitung dari rata-rata selisih proyeksi pendapatan jangka panjang dari kelompok pelanggan yang aktif dalam program loyalitas AI dibandingkan dengan kelompok pelanggan non-aktif.
  • $C_{\text{reward}}$ adalah biaya riil pengadaan unit hadiah atau nilai nominal diskon yang diberikan kepada pelanggan (Unit Reward Cost), termasuk biaya komputasi server AI yang dialokasikan untuk memproses rekomendasi tersebut.
  • $F_{\text{friction}}$ (Friction Coefficient) adalah koefisien hambatan, diukur pada skala desimal $1.0$ hingga $2.0$. Mengukur seberapa rumit langkah yang harus dijalankan pelanggan untuk mendapatkan dan menukarkan hadiah mereka (misalnya, navigasi aplikasi yang lambat, keharusan mengisi formulir panjang, atau syarat dan ketentuan penukaran yang berbelit-belit).

Secara analisis manajemen bisnis e-commerce, program retensi Anda dinyatakan berada pada tingkat efisiensi finansial yang sangat sehat dan sangat layak dipertahankan apabila menghasilkan nilai indeks $LRI \ge 2.0$. Ini membuktikan bahwa personalisasi dinamis berhasil memicu penukaran hadiah yang tinggi ($R_{\text{redemption}}$ optimal) dan melipatgandakan nilai belanja jangka panjang ($\Delta LTV$ melesat), sementara biaya pengadaan hadiah ($C_{\text{reward}}$) terkontrol efisien dan hambatan bertransaksi ($F_{\text{friction}}$) ditekan seminimal mungkin mendekati angka $1.0$.

5 Pilar Strategis Merancang Program Loyalitas Berbasis AI

Untuk membangun arsitektur loyalitas digital yang adaptif, menguntungkan, dan disukai oleh pelanggan Anda di tahun 2026, terapkan lima pilar taktis operasional berikut:

1. Segmentasi Kohort Dinamis Menggunakan Machine Learning

Model segmentasi pelanggan tradisional biasanya hanya membagi konsumen berdasarkan faktor demografis sederhana (seperti umur, lokasi, atau jenis kelamin). AI meruntuhkan batasan kaku ini dengan menciptakan kohort perilaku dinamis (predictive behavioral cohorts) yang terus diperbarui setiap detiknya berdasarkan interaksi nyata pelanggan di situs web Anda.

  • Actionable Step: Integrasikan algoritma pembelajaran mesin tanpa pengawasan (unsupervised machine learning seperti k-means clustering) ke dalam database transaksi Anda. Biarkan AI mengelompokkan pelanggan ke dalam kategori mikro-perilaku yang dinamis, seperti: kelompok pelanggan sensitif harga (discount seekers), kelompok pelanggan yang loyal pada kenyamanan pengiriman cepat (convenience lovers), atau kelompok pembeli impulsif saat peluncuran produk baru. Sesuaikan jenis hadiah loyalitas Anda agar selaras dengan kebutuhan spesifik masing-masing kohort perilaku tersebut harian.

2. Penentuan Hadiah Dinamis Berbasis Konteks Real-Time (Contextual Rewards)

Di era 2026, memberikan diskon ulang tahun setahun sekali adalah cara kerja yang terlalu lambat. AI memungkinkan Anda memberikan hadiah mikro secara real-time tepat di momen psikologis terbaik saat pelanggan sedang berinteraksi di dalam aplikasi Anda (instant gratification).

  • Actionable Step: Rancang pemicu otomatis (automated behavioral triggers) di dalam dasbor e-commerce Anda via API. Sebagai contoh, jika sistem AI mendeteksi seorang pelanggan setia dari kohort “pencinta kopi susu” sedang memasukkan produk kopi susu ke dalam keranjang belanja namun ragu-ragu menyelesaikan pembayaran (cart abandonment) selama 3 menit, sistem AI dapat langsung memunculkan notifikasi pop-up personal: “Khusus untuk Anda hari ini, selesaikan transaksi dalam 10 menit ke depan dan dapatkan gratis ekstra topping kelapa favorit Anda secara langsung.” Hadiah kontekstual yang instan ini terbukti menaikkan konversi checkout hingga $45\%$.

3. Menggamifikasi Pengalaman Loyalitas (Gamified Milestone Rewards)

Mengumpulkan poin secara pasif sangat membosankan bagi psikologi konsumen baru. Manfaatkan sifat alami manusia yang menyukai tantangan, pencapaian, dan pengakuan status sosial melalui integrasi elemen gamifikasi (gamification mechanics) di dalam program loyalitas Anda.

  • Actionable Step: Buat tingkat keanggotaan (membership tiers) interaktif yang memiliki nama-nama unik yang relevan dengan kepribadian merek Anda. Sediakan papan tantangan mingguan (weekly quests) bagi anggota, misalnya: “Selesaikan 3 kali transaksi pembelian produk kecantikan organik bulan ini untuk membuka lencana khusus ‘Green Ambassador’ dan dapatkan akses prioritas pengiriman gratis seumur hidup.” Visualisasikan progres pencapaian mereka menggunakan grafik diagram yang menarik di halaman dasbor profil aplikasi mereka untuk memicu adrenalin kompetisi yang menyenangkan secara psikologis.

4. Integrasi Layanan Pelanggan Omnichannel (Online-to-Offline Continuity)

Pelanggan tidak melihat bisnis Anda sebagai entitas yang terpisah-pisah antara toko online (situs web/aplikasi) dengan toko fisik di dunia nyata. Mereka mengharapkan adanya kontinuitas pengalaman loyalitas yang mulus (seamless omnichannel experience) di mana pun mereka berinteraksi dengan merek Anda.

  • Actionable Step: Integrasikan sistem POS (Point of Sale) toko fisik Anda dengan database e-commerce pusat menggunakan jaringan awan terpadu harian. Pastikan bahwa ketika seorang pelanggan VIP berbelanja di gerai fisik Anda di mall, asisten penjualan di kasir dapat langsung menyapa nama pelanggan tersebut, mengetahui preferensi ukuran baju mereka berdasarkan data riwayat belanja online, serta menawarkan penukaran poin hadiah loyalitas digital mereka secara instan di meja kasir fisik menggunakan pemindaian kode QRIS.

5. Keamanan Data Biometrik dan Kepatuhan Privasi Sesuai UU PDP No. 27/2022

Membangun program loyalitas yang sangat personal membutuhkan pengumpulan data perilaku dan privasi konsumen dalam skala besar. Kelalaian dalam menjaga kerahasiaan data ini dapat menghancurkan seluruh reputasi bisnis Anda secara instan akibat sanksi hukum negara.

  • Regulasi Lokal: Berdasarkan Undang-Undang Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi (UU PDP) di Indonesia, setiap pengendali data wajib mendapatkan persetujuan tertulis yang jelas (explicit opt-in consent) dari pelanggan sebelum memproses data preferensi mereka menggunakan sistem algoritma AI. Pelanggan juga wajib diberikan hak yang mudah untuk menarik kembali persetujuan data mereka (right to be forgotten) kapan saja secara instan.
  • Actionable Step: Rancang halaman persetujuan ketentuan data (privacy policy) yang transparan dan mudah dipahami dengan bahasa yang ramah manusia di aplikasi Anda. Berikan edukasi yang tulus kepada pelanggan bahwa data perilaku mereka dikumpulkan semata-mata untuk meningkatkan kenyamanan personalisasi hadiah mereka, dan pasang sistem enkripsi data tingkat tinggi (AES-256) untuk mengamankan database privasi tersebut dari potensi kebocoran siber harian.

Perspektif Sosiokultural di Indonesia: Menyelaraskan Nilai Kebersamaan

Menerapkan Program Loyalitas Berbasis AI di Indonesia memiliki tantangan dan peluang sosiokultural yang sangat khas. Masyarakat Indonesia memiliki karakter sosiologis yang sangat relasional, menyukai gotong royong, serta memiliki ikatan komunitas yang sangat erat.

Manfaatkan karakteristik unik ini untuk merancang Shared/Community Loyalty Programs menggunakan AI:

  • Actionable Step: Buat program loyalitas kelompok, misalnya “Paket Belanja Keluarga/Komunitas Arisan”. Izinkan beberapa pengguna (misalnya ibu, anak, dan kerabat) untuk menyatukan poin loyalitas mereka ke dalam satu wadah kelompok digital bersama guna ditukarkan dengan hadiah besar yang bernilai tinggi secara kolektif (seperti paket liburan keluarga atau perlengkapan dapur premium). Strategi loyalitas berbasis komunitas ini sangat selaras dengan nilai kebersamaan nusantara, memicu viralitas rujukan mulut ke mulut secara masif, sekaligus memperluas basis akuisisi pelanggan baru Anda dengan biaya organik yang minimal harian.

Kesimpulan: Retensi Cerdas Adalah Kunci Kemakmuran Abadi

Dunia bisnis retail dan e-commerce di tahun 2026 tidak lagi berpihak pada merek-merek yang memperlakukan pelanggan mereka sebagai angka statistik yang seragam dan dingin harian. Penerapan Program Loyalitas Berbasis AI adalah kompas baru untuk memanusiakan kembali transaksi digital melalui kekuatan personalisasi, empati teknologi, serta kecepatan respons.

Bagi Anda pengambil keputusan bisnis pembaca setia Bizonara.com, mulailah membongkar sistem poin kaku Anda dari sekarang. Investasikan sumber daya Anda untuk melatih algoritma AI retensi yang adaptif, sajikan apresiasi hadiah dinamis yang tulus di setiap momen terbaik pelanggan, patuhi regulasi hukum pelindungan data siber negara secara disiplin, dan bangunlah sebuah ekosistem kemitraan yang harmonis bersama komunitas pembeli Anda. Karena pada akhir-akhirnya, kesuksesan bisnis yang berkelanjutan tidak ditentukan oleh seberapa gencar Anda mengejar transaksi pertama pelanggan baru, melainkan oleh seberapa tulus Anda merawat dan mengapresiasi loyalitas dari setiap pelanggan setia yang telah menaruh kepercayaan hidup mereka pada produk Anda.